ドメイン向けllms.txt:どのAIエージェントでも読めるAPI
namefi.io/llms.txtを詳しく解説します。プレーンテキストファイルでAIエージェントがレジストラの全APIを発見・利用できる仕組みと、MCPとの連携を紹介します。
- ai-agents
- domains
- explainer
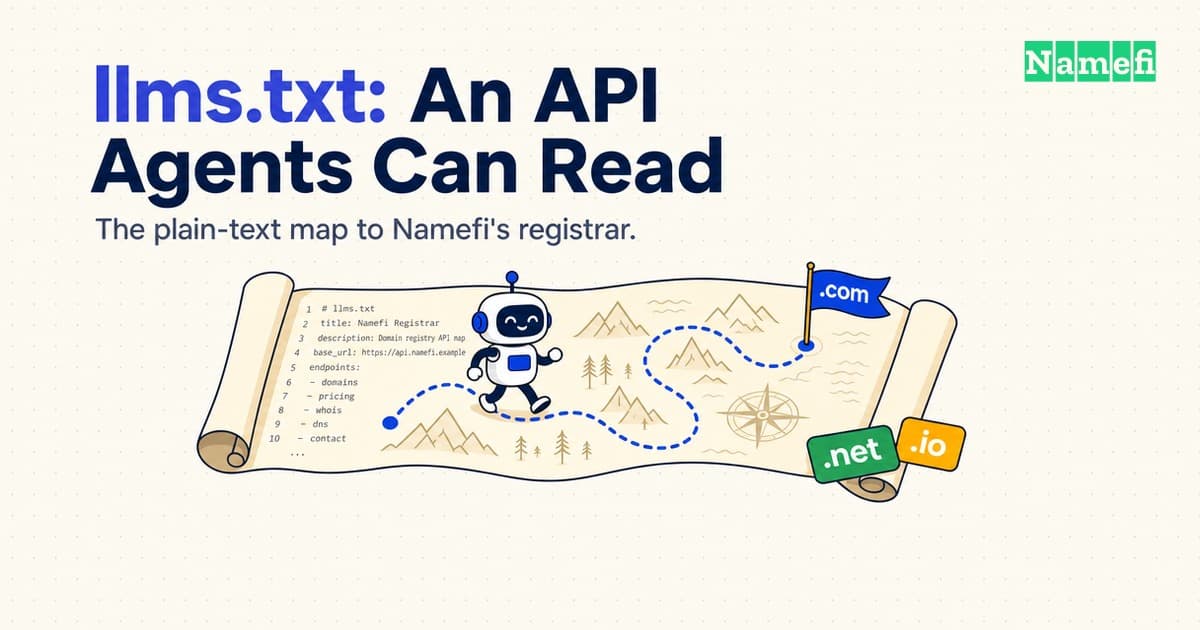
APIを備えたすべてのレジストラには、どこかにドキュメントがあります。ドキュメントサイトやリファレンスページ、場合によってはログインの向こうにあるOpenAPI仕様です。これで二十年間は十分でした。読者は人間の開発者であり、画面をたどり、ナビゲーション部分を読み飛ばして、必要な一段落を見つけられたからです。しかし、推論時に同じサイトを読むAIエージェントには、そんな余裕はありません。コンテキストの予算は限られ、JavaScriptで描画されるドキュメントポータルを待つこともできず、APIの機能を一度で理解できなければ、諦めるか、存在しないエンドポイントを作り出してしまいます。
llms.txtはこの問題を解決する仕組みで、Namefiはnamefi.io/llms.txtで公開しています。この記事では、この規約とは何か、なぜ存在するのか、Namefiのファイルに何が含まれるのかをセクションごとに説明し、意図的に対象外としている範囲と、Model Context Protocol(MCP)と競合するのではなく共存する方法を解説します。また設計どおり、説明対象そのものの実例にもなっています。公開APIの提供者が、自社の機械可読ディスカバリーファイルを平易な文章で説明する記事です。
エージェントがドキュメントサイトをそのままクロールできない理由
llms.txtの根拠は憶測ではなく、提案書に直接記されています。Jeremy Howardによる最初の解説は、提案のきっかけとなった制約から始まります。「大規模言語モデルはウェブサイトの情報にますます依存していますが、重大な制約があります。コンテキストウィンドウが小さすぎて、ほとんどのウェブサイトを全体として扱えません。ナビゲーション、広告、JavaScriptを含む複雑なHTMLページをLLM向けのプレーンテキストに変換することは、困難であるうえに不正確です。」
これは二つの問題が重なっています。実際のドキュメントサイトには、ナビゲーション、変更履歴、マーケティング文、Cookieバナーがあり、エージェントが一つの作業に必要とする数段落に比べれば、その大半はノイズです。しかも、その多くはヘッドレスな取得処理では実行されないJavaScriptの背後にあるため、エージェントのHTTPクライアントが見る内容は、人間が見るページとさえ一致しません。llms.txtはその両方を回避します。クロールして削るのではなく、全体を読むために作られた単一のプレーンテキストMarkdownファイルです。
robots.txtとの類似点と、異なる点
ウェブ基盤に詳しい人にとって、robots.txtとの比較はllms.txtを理解する最も速い方法であり、一定の範囲では妥当です。robots.txtはウェブクローラーに指示を与えるために存在します。サイト自身の説明では、「ウェブサイトの所有者は、サイトについてウェブロボットに指示を与えるために/robots.txtファイルを使います。これはRobots Exclusion Protocolと呼ばれます。」どちらのファイルも予測可能なルートパスに置かれ、プレーンテキストで、人間ではなく自動化された読み手を対象とします。
類似点が途切れるのは目的です。robots.txtはほぼ全面的に否定的な指示であり、Disallow: /some-pathはクローラーに触れてはならない場所を伝えます。llms.txtは肯定的です。このサイトが何であり、読む価値のある部分がどこにあるかを示します。本全体を流し読みできない読者にとって、柵というより目次です。二つは補完関係にあり、Namefiのサイトでは両方を運用しています。
仕様が実際に求めているもの
llms.txtは自由形式ではありません。提案では、特定のMarkdown構造が順番どおりに定義されています。省略可能なバイトオーダーマーク、サイト名を含む必須のH1、概要の引用ブロック、見出しのない詳細セクションをゼロ個以上、そして[name](url): notes形式のリンクを並べるH2区切りの「ファイル一覧」セクションをゼロ個以上です。一つのH2見出しには特別な意味があります。Optionalという名前のセクションは、「より短いコンテキストが必要なら、ここにあるURLは省略できる」ことを示します。Namefiのファイルはその見出しを正確に使用し、仕様どおりの役割を持たせています。
namefi.io/llms.txtを順に見る
以下では公開中のファイルをセクションごとに注釈付きで紹介します。実際に何が書かれ、なぜ初めて読むエージェントに適した形になっているのかを説明します。
| セクション(ファイル内の表記) | 記載内容 | この形にした理由 |
|---|---|---|
| H1 + 引用ブロック | # Namefi API / > Namefi lets you register traditional domains as NFTs and manage their DNS records via API. | 仕様が求める冒頭部分です。ほかを何も読まなくてもエージェントが行動に移せる一文です。 |
| 概要内のMCPへのポインター | MCP server (every operation below as MCP tools): https://api.namefi.io/mcp — discovery descriptor at https://namefi.io/.well-known/mcp/servers.json | 最速の経路である実際のプロトコル接続を、プレーンテキストの経路より先に、冒頭の三行で提示します。 |
## Base URLs | https://api.namefi.io/v-next/ | 文章のない一行です。生のHTTP呼び出しを組み立てるエージェントに必要なのは、まさにこれだけです。 |
## MCP Server (for AI agents) | 「クライアントが対応している場合はMCPを優先します……Claude Codeへの追加:claude mcp add --transport http namefi https://api.namefi.io/mcp --header "x-api-key: YOUR_KEY"」 | 方針を示し、段落ではなく、コピーしてそのまま使える一つのコマンドで裏付けます。 |
## Authentication | 「https://namefi.io/api-key でキーを生成します……すべての操作で利用できます……直接HTTPを利用する場合(AIエージェントに推奨): ヘッダーを直接渡します。SDKは不要です」 | 書き込み呼び出しの認証にSDK、OAuthの手順、ブラウザーセッションのいずれも不要であることを明確に伝えます。 |
## Domain Registration | 三段階のcurl手順:利用可能性を確認し、POST /v-next/orders/register-domainを送信し、最終状態になるまでGET /v-next/orders/{orderId}をポーリング | リクエストやレスポンスの形を文章で説明するのではなく、実行可能なコマンドで中心となる処理を示します。 |
## DNS Record Management | GET/POST/PUT/DELETEによる十一個のエンドポイント(/v-next/dns/records、/v-next/dns/park、/v-next/dns/forwardingなど)を、メソッド、パス、認証、一行の説明とともに示す表 | 似たエンドポイントが多数あるリファレンスデータなので、十一段落ではなく表にまとめています。 |
| トラブルシューティング注記 | 「UNAUTHORIZED (401): APIキーが無効、期限切れ、またはドメイン所有者のウォレットに関連付けられていません……レコード検証エラー: zoneNameの末尾にドットがないこと、CNAME/MX/NSタイプのrdataの末尾にドットがあることを確認してください……」 | 一般的なステータス表ではなく、エージェントが最初に遭遇しやすい失敗を原因と解決策の形で先回りして説明します。 |
## Optional | TypeScript SDKドキュメント、@namefi/api-client npmパッケージ、機械可読OpenAPI 3仕様、アウトバウンドエージェントガイド、署名者に依存しないヘルパースクリプトのGitHubリポジトリへのリンク | 仕様自身が「短いコンテキストが必要なら省略する」ために定めたセクションです。上にある基本手順の前提ではなく、より深い資料をまとめています。 |
ファイルの末尾にはnamefi.io/llms-full.txtへの案内があります。これは同じ内容を一つのドキュメントにインライン展開したもので、ルートファイルではリンクのみのWeb3決済フローとアウトバウンドガイドも含みます。この分割は、仕様自体の二層構造を反映しています。入口はコンテキストに無理なく収まる短さに保ち、さらに必要なエージェントは一つのリンクをたどります。
関連ファイル:Web3とMCPディスカバリー
ルートファイルは、汎用の入口に含める必要がないAPI部分を関連ファイルへ分けています。namefi.io/web3/llms.txtでは、APIキーの代わりにウォレットを持つエージェントが必要とする決済経路を説明します。GET /x402/domain/{domainName}が、価格情報を含む402 Payment Requiredを返し、署名済みX-PAYMENTヘッダーを付けて支払うx402フロー、mppx CLIで署名するMPP(Machine Payable Protocol)のチャレンジ・レスポンス方式、スマートコントラクトウォレットにも対応する手動EIP-712署名経路です。ファイルには、x402での登録について明確にこう書かれています。「NamefiアカウントもEIP-712署名も不要です。購入者のウォレットがEIP-3009のtransferWithAuthorizationに署名します。」APIキーだけが必要なエージェントは、これらを読み込む必要がありません。
MCP側にはllms.txtとは完全に別のディスカバリーファイルがあります。namefi.io/.well-known/mcp/servers.jsonです。Markdownではなく、小さなJSONディスクリプターになっています。
{
  "servers": [
    {
      "name": "namefi-api",
      "transport": "streamable-http",
      "url": "https://api.namefi.io/mcp",
      "authentication": {
        "type": "apiKey",
        "in": "header",
        "name": "x-api-key"
      },
      "documentation": "https://namefi.io/llms.txt"
    }
  ]
}
このディスクリプターは.well-known/以下に置かれます。機械が発見できるメタデータに/.well-known/security.txtが使用するのと同じ規約です。llms.txtのMarkdown文章方式に対する、用途が限定されたJSON型の関連ファイルです。最後のフィールドはllms.txtを参照しているため、先にMCPサーバーを見つけたエージェントにも、そのツールの機能を説明するプレーンテキストへの経路があります。
含まれるもの、含まれないもの、その理由
いくつかの選択は意図的に見えます。ほぼすべての操作が、リクエストスキーマを説明する段落ではなく、実行可能なcurl呼び出しになっています。要約を書くものではなく、コードを実行するもののために書かれたファイルだからです。ルートファイルはすべてを含めず外部にリンクし、llms-full.txtは参照先の内容をインライン展開します。仕様自体のサイズ管理パターンを文字どおり適用したものです。## OptionalセクションはMarkdownと並べて完全なOpenAPI 3仕様にリンクしているため、厳密に型付けされたスキーマを必要とするツールにも、主要な読解経路を煩雑にせず提供できます。また、ウォレットベースの決済であるx402、MPP、EIP-712は独自のファイルに置かれ、APIキー認証と登録手順がすべてのエージェントの最初の読み物になるようにしています。
llms.txtとMCP:発見と接続
それぞれの役割を正確に区別することが重要です。llms.txtはドキュメントです。エージェントは一度取得すると、APIが何であり、詳しいリソースがどこにあるかを理解します。誰かが記載内容に基づいて行動するまでは、静的なテキストです。MCPは、プロトコル自身の説明によれば、「AIアプリケーションを外部システムに接続するためのオープンソース標準」です。クライアントがサーバーとの間に開く実際のセッションであり、呼び出し可能なツールを一覧にして実行できます。
Namefiのファイルは両者の関係を直接示しています。llms.txtは、MCPサーバーがapi.namefi.io/mcpに存在するとエージェントに伝え、接続用のclaude mcp addコマンドを示します。ファイルを読み、実際のツールインターフェースがあることを知り、接続し、実行するという流れです。最初からMCPを使うエージェントも.well-known/mcp/servers.jsonでサーバーを見つけられます。ただし、そのディスクリプターのdocumentationフィールドはllms.txtを参照するため、両者が完全に独立して動作することはほとんどありません。
ほかのAPI提供者への指針
実用的なllms.txtを公開するために、ドキュメントを作り直す必要はありません。
- H1、概要、最速の接続方法を冒頭に置く — コンテキストの小さいエージェントは、最初の数行より先を読まない可能性があります。
- スキーマの説明文ではなく、実行可能なリクエストを示す。 実際のフィールド名を含む
curlコマンドは、JSON本文を説明する段落より役に立ちます。 - チーム構成ではなく、サイズで分割する。 短いルートファイルと詳細版を用意し、決済など個別の関心事を別ファイルにすると、一般的な経路を短く保てます。
- ステータスコードだけでなく、実際の失敗原因を記載する — 401と403のどちらを返すかという数字より、なぜ返るのかが重要です。
- 省略可能な内容には、仕様の規約どおり
## Optional見出しを使う。 - MCPサーバーを運用しているなら、llms.txtと一緒にMCPディスカバリーディスクリプターを公開する — 一方は「これは何か」に、もう一方は「どう接続するか」に答えます。
よくある質問
llms.txtとは何ですか?
正式なIETFまたはW3C標準ではなく、提案中の規約です。ウェブサイトのルートにプレーンテキストのMarkdownファイルを公開し、サイトやAPIが何であるか、詳しい情報がどこにあるかをAIエージェントに伝えます。H1タイトル、概要の引用ブロック、省略可能な詳細段落、H2区切りのリンク一覧という特定の順序が定義され、「Optional」見出しは省略可能な内容のために予約されています。
llms.txtはrobots.txtとどう違いますか?
robots.txtは、Robots Exclusion Protocolに基づいて、ウェブクローラーにインデックスしてはならないものを伝える否定的な指示です。llms.txtは、サイトが何であり、読む価値のあるものは何かを伝える肯定的な案内です。異なる自動化された読み手を対象とし、通常は同じサイトに共存します。
llms.txtはMCPに取って代わりますか?
いいえ。llms.txtはAPIの機能を理解するためにエージェントが一度読むドキュメントです。MCPは、実際にAPIの操作を呼び出すためにクライアントが開くライブなプロトコル接続です。Namefiは両方を公開しており、そもそもMCPサーバーが存在するとエージェントに伝えるのがllms.txtです。
Namefiのllms.txtファイルには何が含まれていますか?
ベースURL、MCPサーバーへのポインター、APIキー認証セクション、実行可能なcurl例を使う三段階のドメイン登録フロー、DNSレコード管理エンドポイントの表、ドメイン設定エンドポイント、トラブルシューティングセクション、SDK、OpenAPI仕様、ウォレット決済およびアウトバウンドワークフローの関連ファイルへリンクする「Optional」セクションです。
AIエージェントなしで、自分でllms.txtを読めますか?
はい。プレーンなMarkdownなので、モデルだけでなく人間にも読めます。namefi.io/llms.txtは簡潔なAPIクイックリファレンスとして読めます。人間が流し読みしやすい明快さは、モデルが正確に解析するためにも役立ちます。
出典と参考資料
- llmstxt.org — /llms.txtファイル:背景、提案、形式仕様
- robotstxt.org — /robots.txtについて:「要するに」
- modelcontextprotocol.io — Model Context Protocol(MCP)とは?
- Namefi — namefi.io/llms.txt(この記事で注釈したすべての抜粋の一次資料)
- Namefi — namefi.io/web3/llms.txt(x402、MPP、EIP-712によるウォレット決済フロー)
- Namefi — namefi.io/.well-known/mcp/servers.json(MCPディスカバリーディスクリプター)
- Namefi — namefi.io/llms-full.txt(Web3およびアウトバウンドの関連ファイルをインライン展開した単一ファイル版)
- IETF — RFC 8615:Well-Known Uniform Resource Identifiers(
.well-known/規約)
自分でファイルを読んでみる
llms.txtを理解する最も速い方法は、実例を開くことです。namefi.io/llms.txtは公開され、認証なしで利用でき、この記事を読むのにかかった時間で読み切れるほど短いファイルです。Namefiに接続するすべてのAIエージェントが最初に読むのも同じファイルです。その背後にあるMCPツールの実際の機能はNamefi MCPサーバー:AIエージェント向けドメインツールを、エディターから接続する方法はMCPクイックスタートを、エージェントが全体の流れを実行する様子はNamefiでAIエージェントを使ってドメインを登録する方法をご覧ください。
執筆・編集メンバー
Aileen Wrightはニューヨーク市で暮らす20代の学生です。この街では、美術館から 図書館の閲覧室までは歩いてすぐですが、その二つを巡れば午後いっぱいを過ごせます。 彼女が名前について書くようになったきっかけは、美術と歴史でした。一枚の肖像画や 一枚の硬貨、あるいは写本の余白が、一つの名前を何世紀にもわたって伝え、その間に 意味を変えていくことに惹かれたのです。
普段の彼女は、ペーパーバックを手にセントラルパークで過ごしたり、公共の 静かな閲覧室で、名前の一覧に書かれた意味ではなく、その名前が本当はどこから 来たのかを調べたりしています。独学でプログラミングも学んでおり、その影響で、 綴りや並べ方、そして名前が長く愛されるかどうかを左右する細部に、人一倍こだわる ようになりました。
Namefiでは、ドメイン名の背景にある歴史と文化、ブランドが名前を変えるときに背負う 物語、そして魅力的な物語と検証済みの出典との違いについて執筆しています。
Victor Zhouは、デジタルアイデンティティと信頼を専門とするテクノロジー企業の創業者で、 標準仕様のエディターでもあります。Namefiを創業し、Ethereum Improvement Proposalsの 編集に携わっています。以前はGoogle Labsでスマートコントラクトのアーキテクチャ設計を 率いていました。
彼の仕事は、ネーミング、所有権、そして人々がオンラインで自らのアイデンティティを 確立するために使うシステムが交わる場所にあります。だからこそ、名前が個人的な意味、 社会的な認知、デジタルインフラの間をどのように行き来するのかに強い関心を持っています。
Namefiでは、永続的なデジタルアイデンティティとしてのドメインについて編集・執筆して います。名前が所有可能なオンチェーン資産になる仕組み、トークン化が保管と信頼をどう 変えるのか、そして人々がオンラインでアイデンティティを確立するために使うシステムから ネーミングが何を学べるのかを扱っています。
Chie Kudō(工藤 知恵)は、福岡を拠点とする30代の翻訳者です。電機メーカーで ハードウェアQAエンジニアとして製品資料の作成と確認に携わった後、英語と日本語の 間で技術記事や編集記事をローカライズする仕事に転じました。
品質保証で身につけた習慣は、今の仕事にも生きています。用語の一貫性はもちろん、 ブランド名を漢字、かな、ローマ字のどれで表すか、半角と全角をどう使い分けるか、 借用元の英語とは異なる意味を持つ和製英語をどう扱うかといった、日本語組版ならではの 細部を厳しく確認します。小さなベランダ菜園を楽しみ、週末にはボルダリングをします。
Namefiでは、ドメインとネーミングに関する記事を日本語にローカライズしています。 名前がページ上でどう読めるか、そして最初から正しく入力してもらえるかに目を配っています。